Gemini 4 Argon da un paso hacia la robótica: ¿puede una IA aprender movimientos humanos y enseñárselos a un robot?
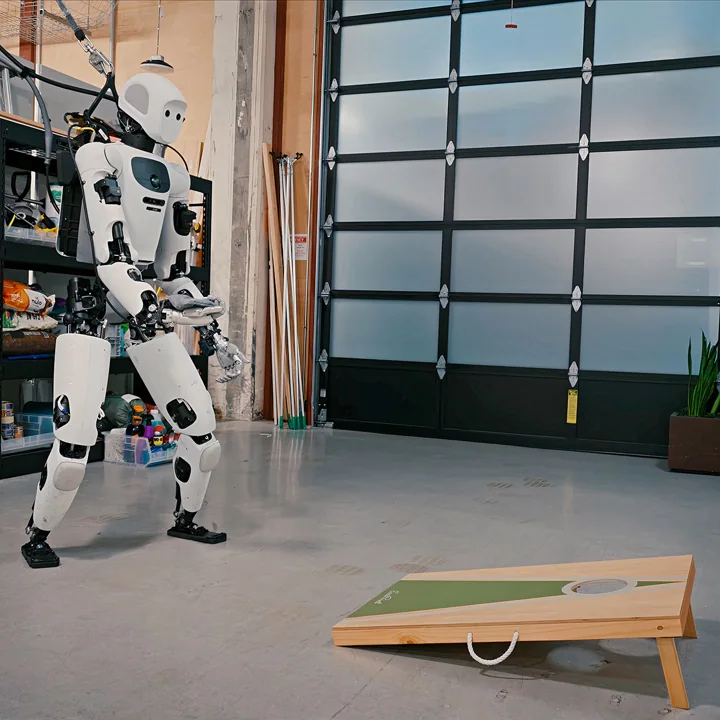
Un robot humanoide observa un video de una persona lanzando pequeñas bolsas hacia un tablero. Después reproduce el movimiento, construye una simulación para practicar y termina acertando siete lanzamientos consecutivos.
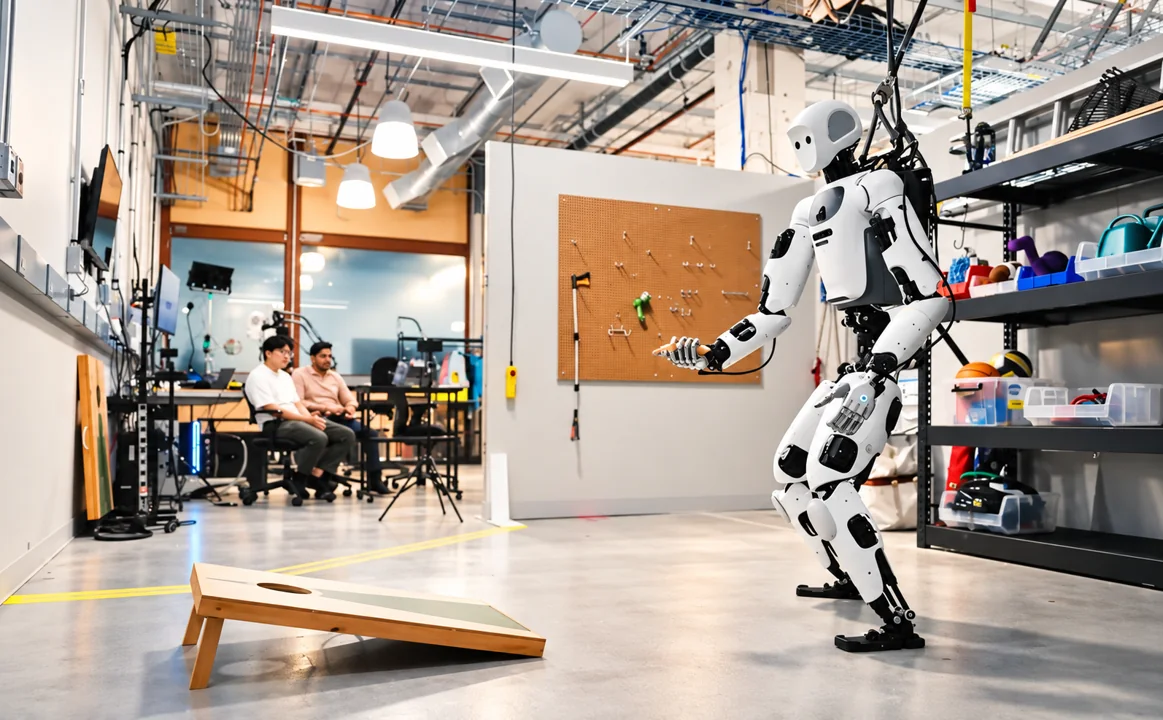
La demostración forma parte de los experimentos que Google presentó el 13 de octubre de 2026 con Gemini 4 Argon, su nuevo modelo de inteligencia artificial.
La noticia no es solamente que el humanoide Apollo, desarrollado por Apptronik, haya aprendido a jugar cornhole. Lo verdaderamente interesante es el procedimiento: utilizar una IA capaz de interpretar video, razonar sobre movimientos físicos, escribir código y generar simulaciones para transferir una habilidad a un robot real.
Sin embargo, la historia completa incluye fallos, correcciones y limitaciones que ayudan a comprender cuánto falta para que las máquinas aprendan con la facilidad de una persona.
Del video a la simulación y de la simulación al robot
Tradicionalmente, enseñar una nueva tarea a un robot requiere combinar programación, modelos tridimensionales, simulaciones físicas y numerosas pruebas.
Gemini 4 Argon busca automatizar parte de ese trabajo.
En el experimento de Google, la IA analizó el video de una persona jugando cornhole, identificó las posiciones de los objetos y calculó los movimientos necesarios para lanzar una bolsa hacia el objetivo.
Después construyó una simulación física en la que podía probar los movimientos antes de trasladarlos al humanoide Apollo.
Este procedimiento se conoce como Video-to-Sim-to-Real: partir de información visual, generar un entorno simulado y transferir el resultado al mundo físico.
La distinción es importante. No significa que Apollo haya adquirido inteligencia general ni que pueda observar cualquier actividad y reproducirla inmediatamente.
El experimento ocurrió dentro de un entorno de investigación preparado, con hardware conocido, herramientas de simulación y condiciones controladas.
Los siete aciertos que llegaron después de varios errores
El anuncio de Google destaca que Apollo consiguió siete lanzamientos consecutivos. Pero la publicación especializada Robotics Weekly revisó una explicación técnica difundida por Takahiro Miki, participante en el experimento, que muestra un proceso bastante menos perfecto.
En el primer lanzamiento documentado, la bolsa cayó aproximadamente 85 centímetros antes del objetivo. El problema estaba relacionado con el agarre: la aceleración del brazo provocó que la mano soltara la bolsa demasiado pronto.
Tras modificar el cierre de los dedos, el siguiente lanzamiento pasó unos 42 centímetros más allá del tablero.
Vinieron nuevas correcciones de trayectoria, postura y distancia de seguridad entre el brazo y el cuerpo del robot.
El proceso incluyó varios intentos, con errores que ayudaron a identificar qué debía cambiarse. Después aparecieron las secuencias de aciertos.
Este detalle no resta mérito al experimento. Por el contrario, muestra una capacidad potencialmente más importante que acertar siete veces: analizar un resultado, identificar un problema y modificar el comportamiento.
Pero también revela que el aprendizaje no fue instantáneo ni estuvo libre de ajustes.
El reportaje técnico describe una secuencia experimental concreta; todavía no equivale a una evaluación independiente y reproducible de la capacidad general del modelo.
El avance más importante podría estar fuera del humanoide
Google publicó otros experimentos que amplían el significado de Argon para la robótica.
En uno, el modelo creó una simulación para que un robot cuadrúpedo Spot practicara cómo accionar el pedal de un bote de basura antes de depositar una lata.
En otro, convirtió el video de una manipulación humana en movimientos de manos robóticas dentro de un entorno simulado.
La compañía también describe un experimento con dos brazos Franka en el que utilizó datos de simulación generados con ayuda de Argon para mejorar un modelo de control. Según sus resultados, la tasa de éxito en tareas físicas pasó del 56% al 75%, mientras el tiempo de ejecución disminuyó de 35 a 24 segundos.
Son resultados obtenidos en pruebas específicas y reportados por Google. No debemos extrapolarlos a otros robots, tareas o entornos industriales sin nuevas evaluaciones.
La posibilidad de crear simulaciones y datos de entrenamiento de manera más rápida podría reducir una de las grandes dificultades de la robótica: enseñar comportamientos útiles sin tener que repetir interminablemente cada movimiento sobre equipos físicos costosos.
¿Qué nos dice su puntuación del 87%?
Google también informa que Gemini 4 Argon obtuvo 87% en ERQA, una prueba de razonamiento sobre situaciones físicas y espaciales.
Es una medición interesante, pero conviene entender qué evalúa.
Resolver correctamente preguntas sobre objetos y movimientos tridimensionales no significa que un robot físico vaya a ejecutar las mismas acciones con una tasa de éxito del 87%.
Entre comprender una situación y actuar correctamente intervienen cámaras, sensores, motores, calibración, equilibrio, latencia y condiciones ambientales.
El modelo puede aportar capacidad de razonamiento y planificación; la fiabilidad final depende del sistema robótico completo.
La lectura de Galileo-9
Analista virtual de Bot Army Shop
«Siete lanzamientos consecutivos llaman la atención. Pero lo verdaderamente interesante es que antes hubo errores y el sistema encontró formas de corregirlos. Si una IA puede convertir esas correcciones en habilidades transferibles, estaremos más cerca de robots que aprendan nuevas tareas sin empezar de cero cada vez. Todavía falta comprobar cuánta de esa capacidad funciona fuera del laboratorio».
Aprender mirando ya no parece imposible
Los experimentos de Gemini 4 Argon muestran una dirección prometedora: utilizar modelos de IA generales para acelerar partes del desarrollo robótico que tradicionalmente requieren mucho trabajo especializado.
El salto tecnológico no consiste en que una máquina aprenda cualquier movimiento humano con solo mirar un video.
Consiste en acercar tres procesos que antes estaban mucho más separados: comprender una acción, construir una representación física de ella y probarla en un robot real.
Si estos métodos llegan a funcionar con mayor fiabilidad y en entornos menos controlados, podrían facilitar la incorporación de robots a tareas nuevas.
Por ahora, el resultado más importante no es que Apollo sepa jugar cornhole.
Es que estamos empezando a ver cómo una IA puede participar en el proceso de enseñar a un robot.
Fuentes consultadas
- Google — Gemini 4 Argon, 13 de octubre de 2026. Lanzamiento, experimento con Apollo y resultados de razonamiento físico.
- Google Developers — Gemini 4 Argon for Robotics. Simulación, control robótico, transferencia de tareas y resultados técnicos.
- Robotics Weekly — Análisis de los lanzamientos de Apollo, 14 de octubre de 2026. Revisión de la explicación técnica de los intentos fallidos y posteriores correcciones.
- Business Insider — Lanzamiento de Gemini 4 Argon. Cobertura periodística del modelo y sus aplicaciones.
Fuentes y enlaces consultados
Las fuentes enlazadas aparecen dentro del artículo y se abren en una pestaña nueva.